Audio in Verlagsdimension bedeutet tausende Artikel, die jeden Tag vertont werden. Bei diesem Volumen ist die ehrliche Frage nicht, ob ein Laufzeitmodell perfektes Audio produziert — sondern wer die Fälle einfängt, in denen es das nicht tut, und wie schnell.
AI Quality Control ist die Antwort, die wir ausgeliefert haben. Eine dreistufige Pipeline läuft nach jeder Vertonung — schnelle Prüfungen, ASR-Nachhören, Urteil des Audiomodells — und jede Prüfung vermisst die Übergänge zwischen den Stimm-Chunks, die akustischen Nahtstellen, an denen die Vertonung bricht. Die stärkste Messung pro Artikel wird behalten und gegen Schwellen bewertet, die pro Verlag gesetzt sind.
Artikel
Was das Dashboard zeigt
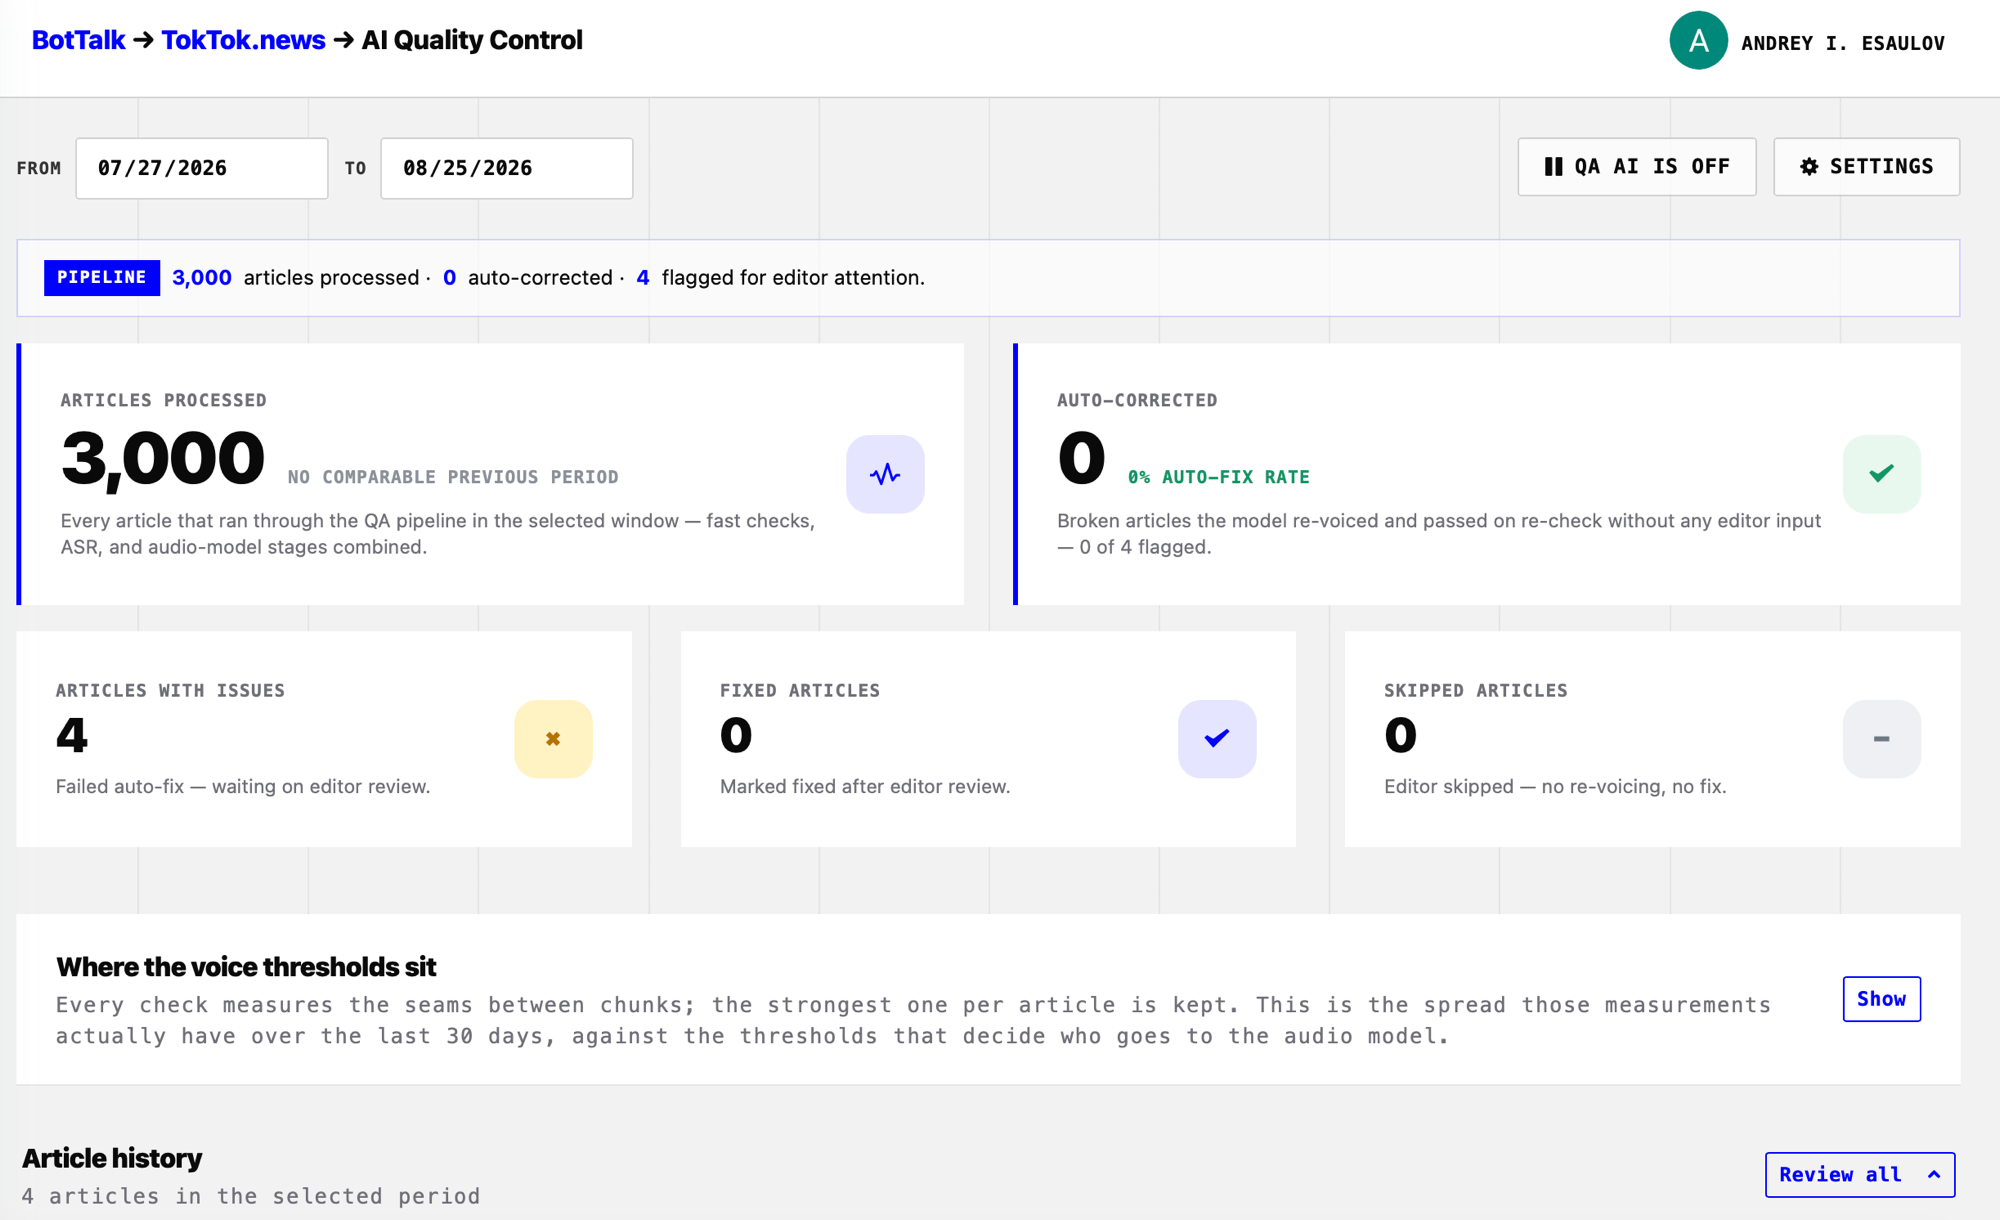
Eine Ansicht pro Verlag, auf einen Datumsbereich zugeschnitten. Die Pipeline zählt jeden Artikel, der durch sie lief, wie viele das Modell neu vertont und beim Nachcheck ohne jeden Redakteurs-Input freigegeben hat, wie viele den Auto-Fix nicht bestanden haben und auf einen Redakteur warten, wie viele Redakteure als behoben markiert haben und wie viele sie übersprungen haben.
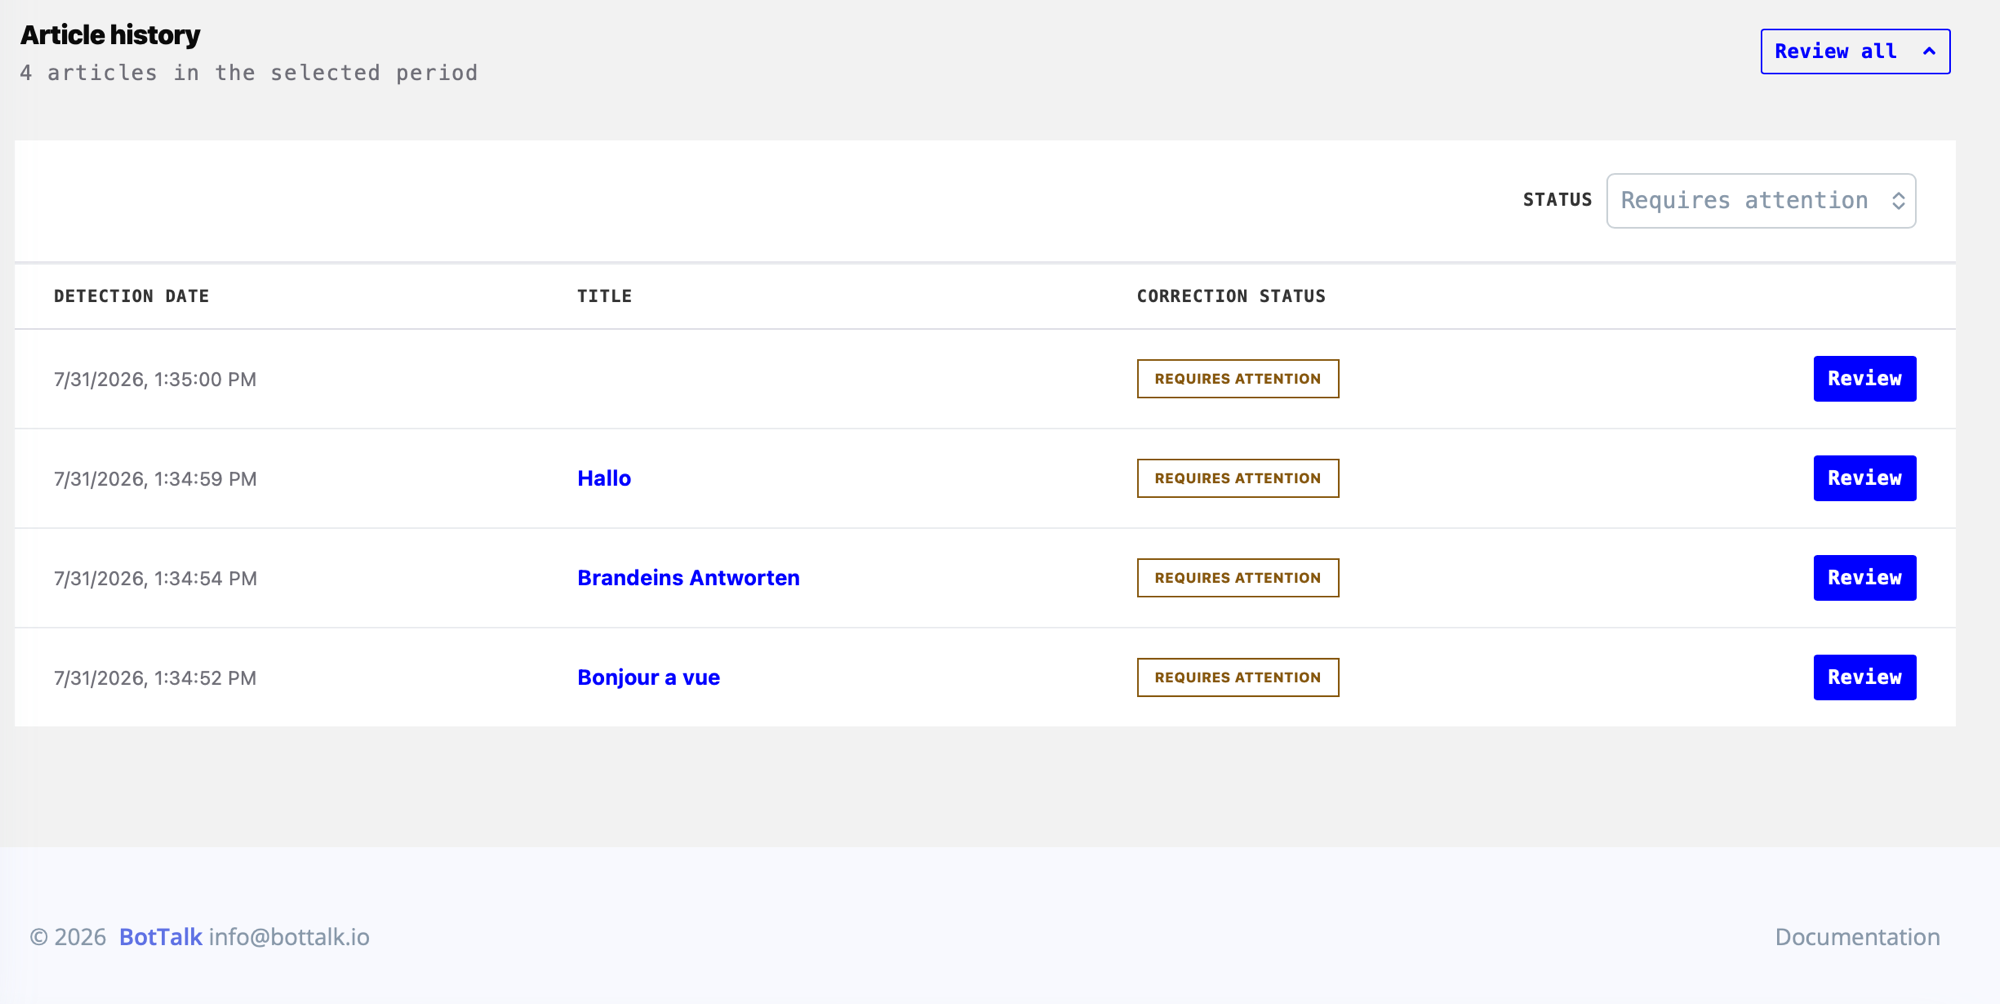
Die Artikel-Historie
Wenn etwas gemeldet wird, muss der Redakteur nicht suchen. Die Artikel-Historien-Tabelle listet jede Erkennung im Zeitraum, sortiert vom neuesten zum ältesten, filterbar nach Status. Jede Zeile öffnet eine Seite-an-Seite-Prüfung: die Passage, die das Modell gehört hat, den Zeitstempel der Nahtstelle und die Option, neu zu vertonen, als behoben zu markieren oder zu überspringen.
Wie das Modell entscheidet, was kaputt ist
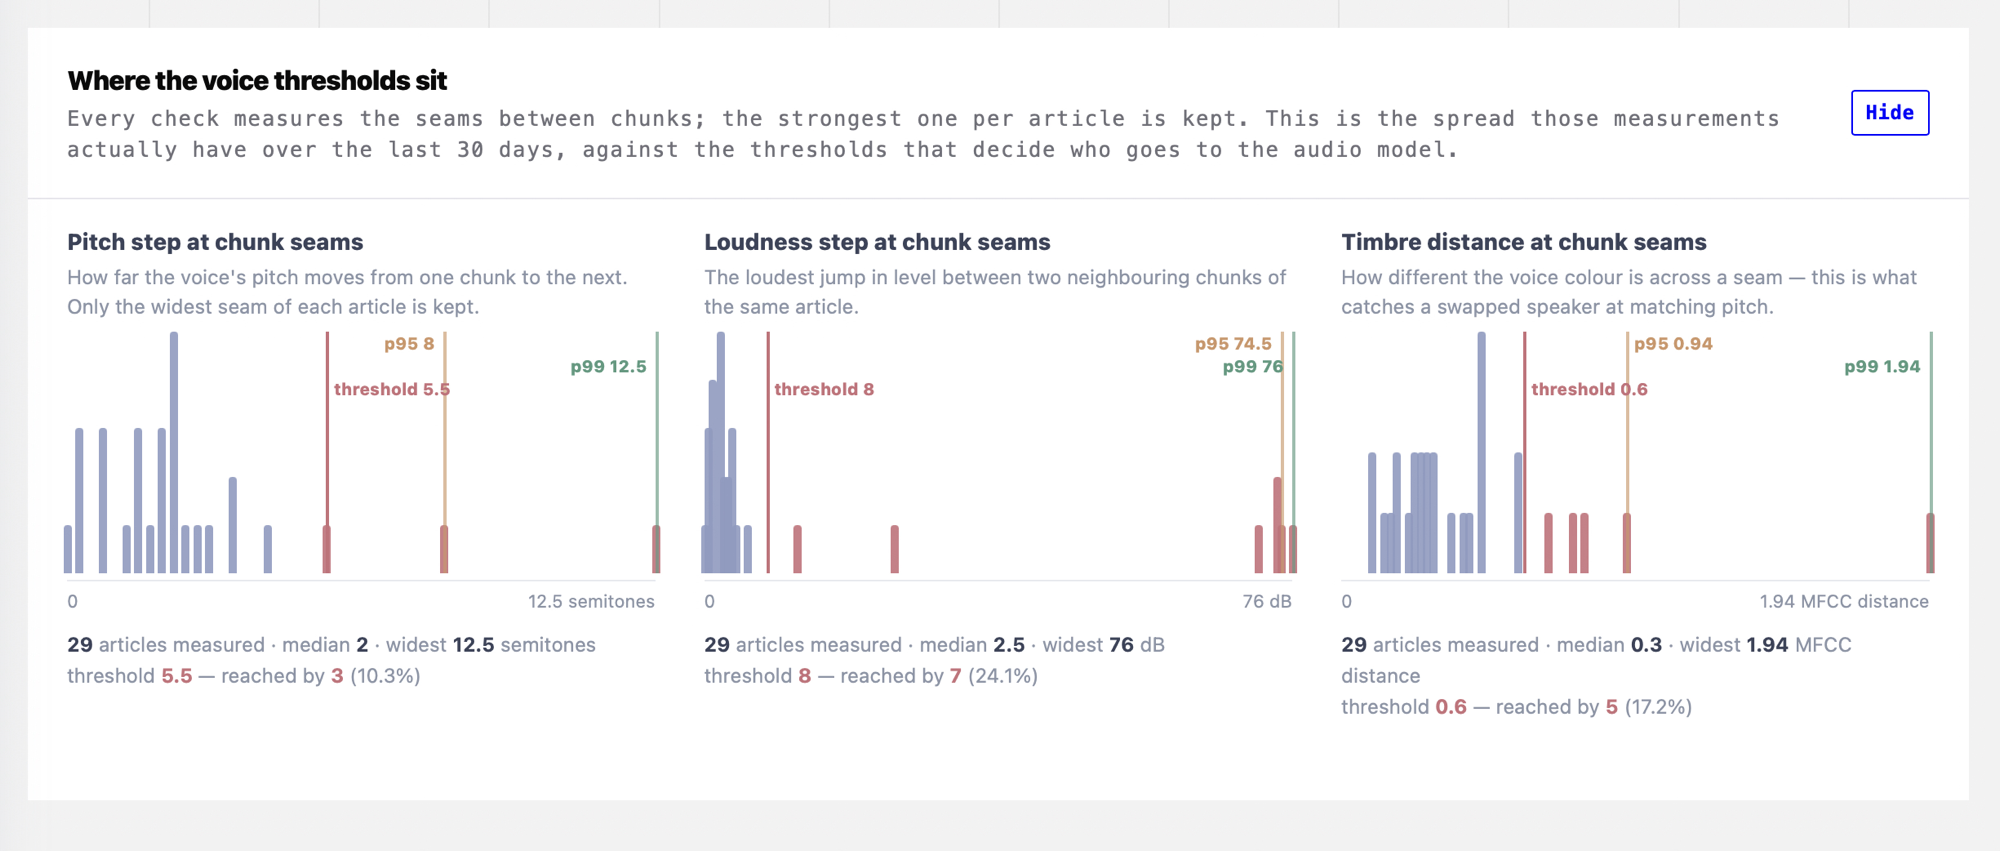
Jede Prüfung fährt drei Messungen an jeder Chunk-Nahtstelle: den Pitch-Sprung (wie weit sich die Tonhöhe der Stimme von einem Chunk zum nächsten bewegt), den Lautheits-Sprung (der schärfste Pegelsprung zwischen zwei benachbarten Chunks) und die Timbre-Distanz (wie unterschiedlich die Stimmfarbe über eine Naht hinweg ist — die Prüfung, die einen getauschten Sprecher bei gleicher Tonhöhe einfängt). Die stärkste Messung pro Artikel wird behalten und gegen Schwellen bewertet, die pro Verlag gesetzt sind.
Warum wir es jetzt ausgeliefert haben
Verlage, die BotTalk betreiben, haben das Volumen erreicht, bei dem perfekte manuelle QA auf jedem Artikel unmöglich ist und gar keine QA nicht hinnehmbar. Redakteure stellten in Standups immer dieselben drei Fragen: wie viele liefen, wie viele brachen, wie viele haben wir bereits behoben, ohne dass ich es wusste. Das Dashboard beantwortet alle drei in der obersten Zeile.
Was heute in der Box ist
- Dreistufige Pipeline — schnelle Prüfungen, ASR-Nachhören, Urteil des Audiomodells — läuft auf jeder Vertonung, pro Verlag.
- Auto-Fix-Schleife für alles, was das Modell beim Nachcheck sauber neu vertonen kann. Wenn es landet, wird der Redakteur nie benachrichtigt.
- Redakteurs-Warteschlange für den Rest: eine filterbare Tabelle, Ein-Klick-Prüfung, drei Verben (neu vertonen, als behoben markieren, überspringen).
- Schwellen pro Verlag, die der Redakteur einstellen kann. Jede Prüfung vermisst die Übergänge zwischen den Chunks; die stärkste Messung entscheidet, wer zum Audiomodell geht.
- Pause-Schalter oben rechts — der Redakteur kann die automatisierte Pipeline mitten am Tag einfrieren, wenn er einen manuellen Durchgang auf dem nächsten Batch will.
Wohin es als Nächstes geht
Zwei Arbeitslinien stehen bereits im Ledger für die nächsten Releases: Stimm-Schwellen pro Verlag als Einstellungs-Panel offengelegt (heute ein interner Regler) und eine kompakte Digest-Mail, die jeder Redakteur abonnieren kann — eine Zahl pro Tag, ein Link ins Dashboard, keine Dashboards zu prüfen, wenn nichts gebrochen ist.