L'audio à l'échelle d'un éditeur, c'est des milliers d'articles mis en voix chaque jour. À ce volume, la vraie question n'est pas de savoir si un modèle produit un audio parfait à l'exécution — c'est de savoir qui rattrape ceux qui ne le sont pas, et à quelle vitesse.
AI Quality Control est la réponse que nous avons livrée. Un pipeline en trois étapes tourne après chaque mise en voix — vérifications rapides, ré-écoute ASR, verdict d'un modèle audio — et chaque vérification mesure les jointures entre segments vocaux, les points de raccord acoustique où la narration se brise. La mesure la plus forte par article est retenue et confrontée à des seuils fixés par éditeur.
Article
Ce que le tableau de bord affiche
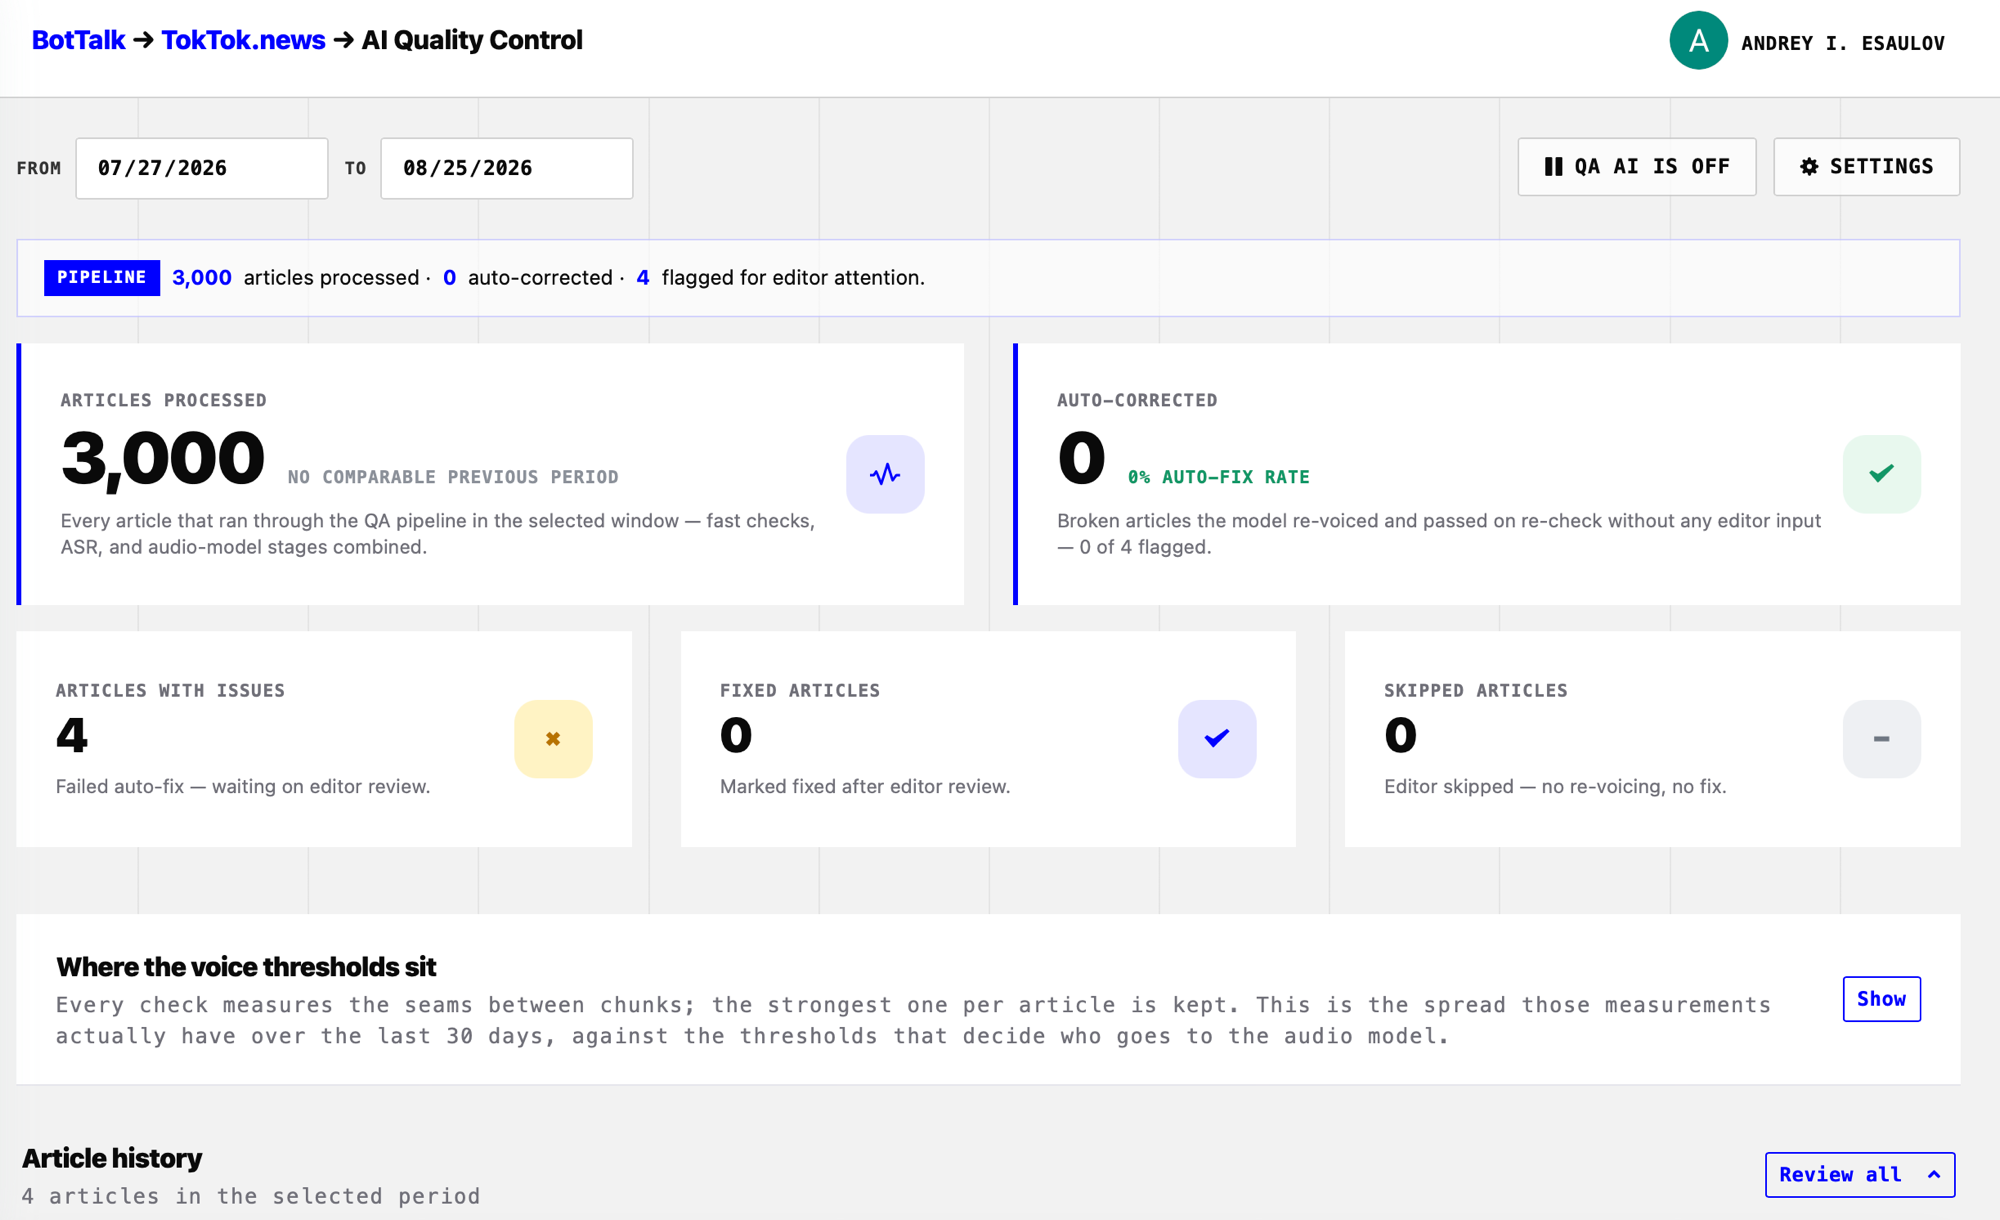
Une vue par éditeur, cadrée sur une plage de dates. Le pipeline compte chaque article qui l'a traversé, combien le modèle a remis en voix et validés à la re-vérification sans aucune intervention éditoriale, combien ont échoué à la correction automatique et attendent la rédaction, combien la rédaction a marqués comme corrigés, et combien elle a choisi d'ignorer.
L'historique des articles
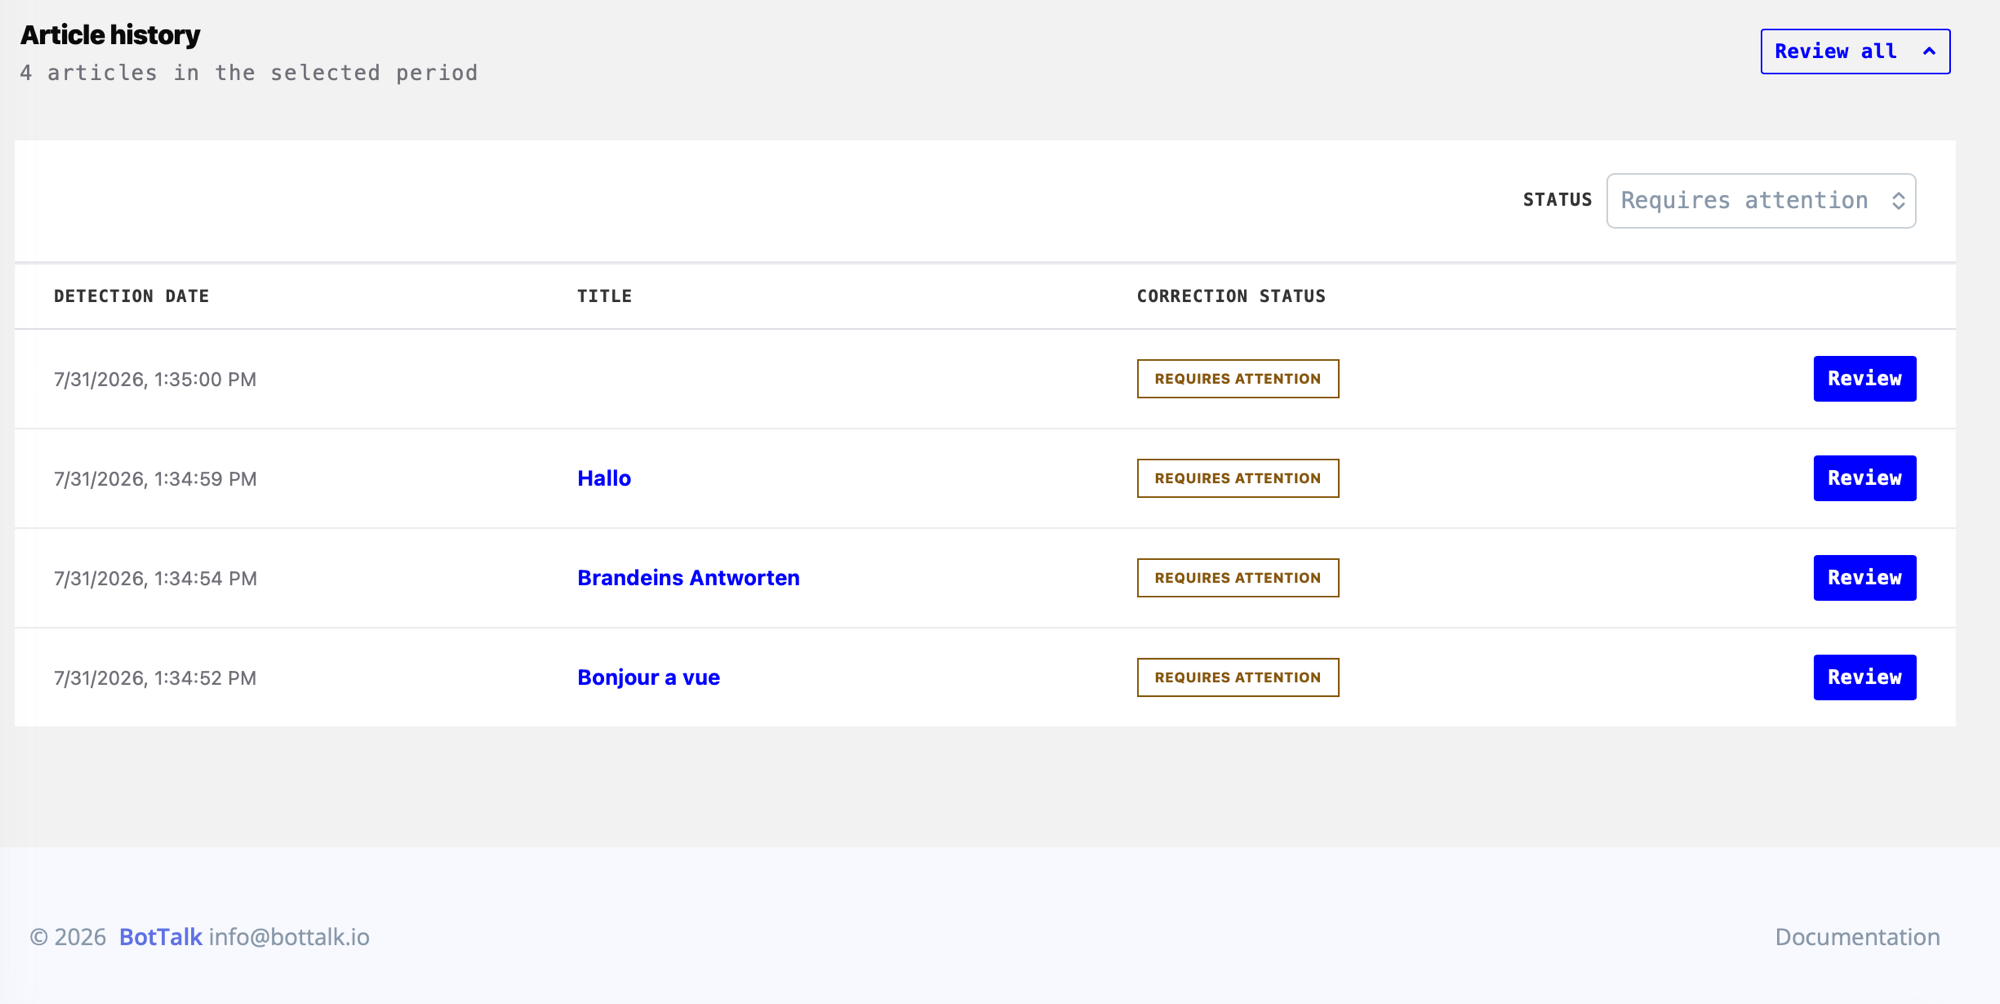
Quand quelque chose est signalé, la rédaction n'a pas à chercher. Le tableau d'historique des articles liste chaque détection dans la fenêtre, triée du plus récent au plus ancien, filtrable par statut. Chaque ligne ouvre une revue côte à côte : le passage que le modèle a entendu, l'horodatage de la jointure, et l'option de remettre en voix, marquer corrigé ou ignorer.
Comment le modèle décide de ce qui est cassé
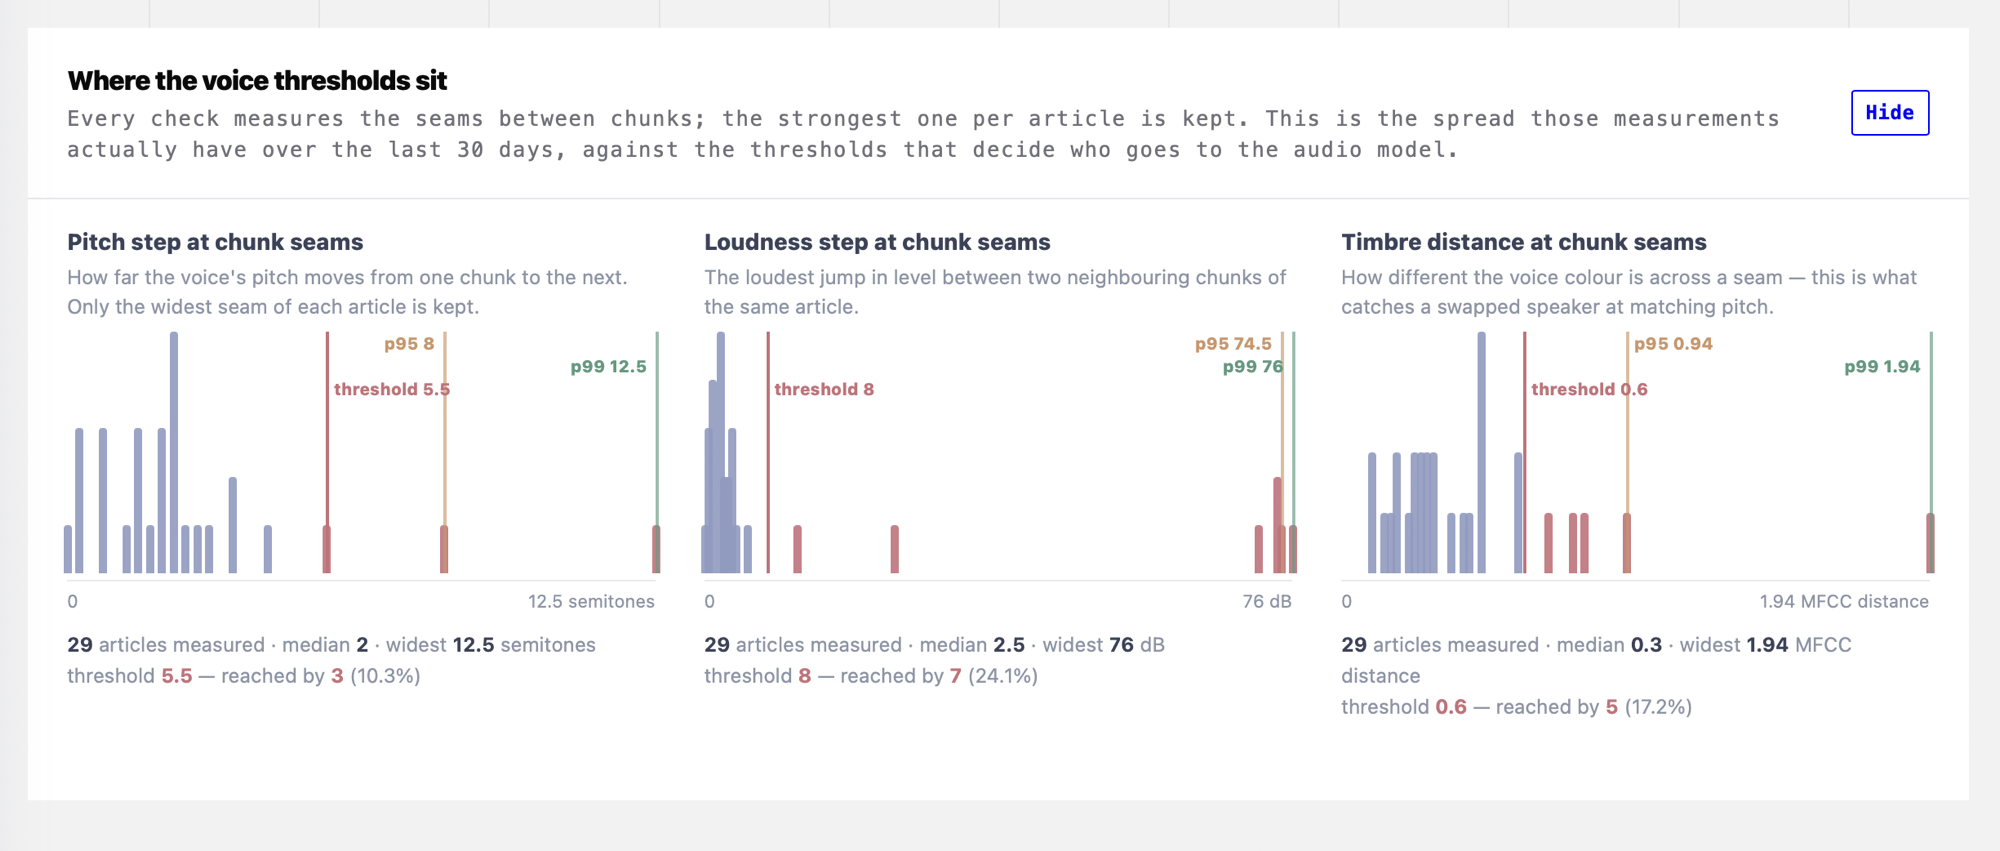
Chaque vérification exécute trois mesures à chaque jointure de segment : le saut de hauteur (à quelle distance la hauteur de la voix se déplace d'un segment au suivant), le saut de volume (le bond de niveau le plus fort entre deux segments voisins) et la distance de timbre (à quel point la couleur vocale diffère de part et d'autre d'une jointure — la vérification qui rattrape un locuteur remplacé à hauteur identique). La mesure la plus forte par article est retenue et confrontée à des seuils fixés par éditeur.
Pourquoi nous l'avons livré maintenant
Les éditeurs qui font tourner BotTalk ont atteint le volume où un QA manuel parfait sur chaque article est impossible et où l'absence totale de QA est inacceptable. Les rédactions posaient sans cesse les trois mêmes questions en stand-up : combien sont passés, combien se sont cassés, combien avons-nous déjà corrigés sans que je le sache. Le tableau de bord répond aux trois dans la première ligne.
Ce qu'il y a dans la boîte aujourd'hui
- Pipeline en trois étapes — vérifications rapides, ré-écoute ASR, verdict du modèle audio — qui tourne sur chaque mise en voix, par éditeur.
- Boucle de correction automatique pour tout ce que le modèle peut remettre en voix proprement à la re-vérification. Quand elle aboutit, la rédaction n'est jamais alertée.
- File éditoriale pour le résidu : un tableau filtrable, une revue en un clic, trois verbes (remettre en voix, marquer corrigé, ignorer).
- Seuils par éditeur que la rédaction peut régler. Chaque vérification mesure les jointures entre segments ; la mesure la plus forte décide qui passe au modèle audio.
- Bouton pause en haut à droite — la rédaction peut geler le pipeline automatisé en pleine journée si elle veut un passage manuel sur le prochain lot.
Où cela va ensuite
Deux chantiers déjà au registre pour les prochaines releases : des seuils vocaux à l'échelle de l'éditeur exposés dans un panneau de réglages (aujourd'hui un curseur interne), et un e-mail de synthèse compact que chaque éditeur pourra recevoir sur abonnement — un chiffre par jour, un lien vers le tableau de bord, aucun tableau à vérifier quand rien n'a cassé.